novel-plus 是一套功能完善的原创文学 CMS 系统,支持 PC 网站、WAP、H5、Android、iOS 和微信小程序等多个终端,提供一站式小说平台搭建解决方案。
由前台门户系统、作家后台管理系统、平台后台管理系统和爬虫管理系统等多个子系统构成,包括小说推荐、作品检索、小说排行、小说阅读、小说书评、段落评论、小说书单、会员中心、作家专区等功能。
支持自定义多模版、可拓展的多种小说内容存储方式(内置数据库分表存储和 TXT 文本存储)、阅读主题切换、自动采集和更新测试数据、AI写作、会员充值、订阅模式、新闻发布和实时统计报表。
以前,novel-plus 的爬虫规则主要依赖正则表达式,对不熟悉正则的用户来说,上手门槛相对较高。
现在,采集正式支持 CSS、XPath、正则表达式、JSONPath 四种解析方式,并在此基础上尝试实现了 第三方规则导入 功能,希望降低规则编写和迁移的成本。
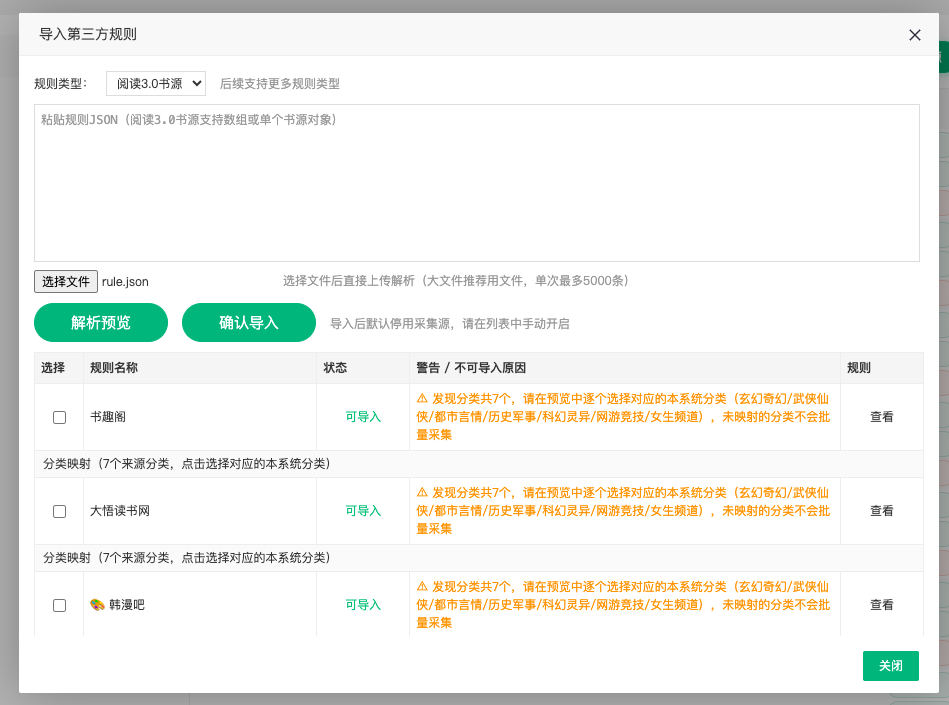
目前,第三方规则导入功能 仅支持阅读 3.0 格式。
为了验证方案是否可行,我从网上公开的阅读 3.0 书源中随机挑选了一批规则,尝试导入了十几条。测试结果并不算理想,绝大部分规则无法直接使用,问题主要集中在以下几个方面:
- 域名失效:原站点无法正常访问。
- 地域限制:部分站点对访问来源有限制。
- 访问限流:请求频率受到限制,无法正常采集。
- 反爬机制:站点增加了额外的访问校验。
- 规则不兼容:部分规则依赖
@js:动态脚本,或者使用了暂未适配的多行组合规则。
针对地域限制、访问限流以及部分反爬问题,可以参考这篇文章:一站式解决爬虫采集难题:提速、稳定访问与 IP 限制
不过,也有少数规则成功导入,并且能够正常采集内容。这说明,第三方规则导入这条路是可行的,后续仍有继续完善的空间。
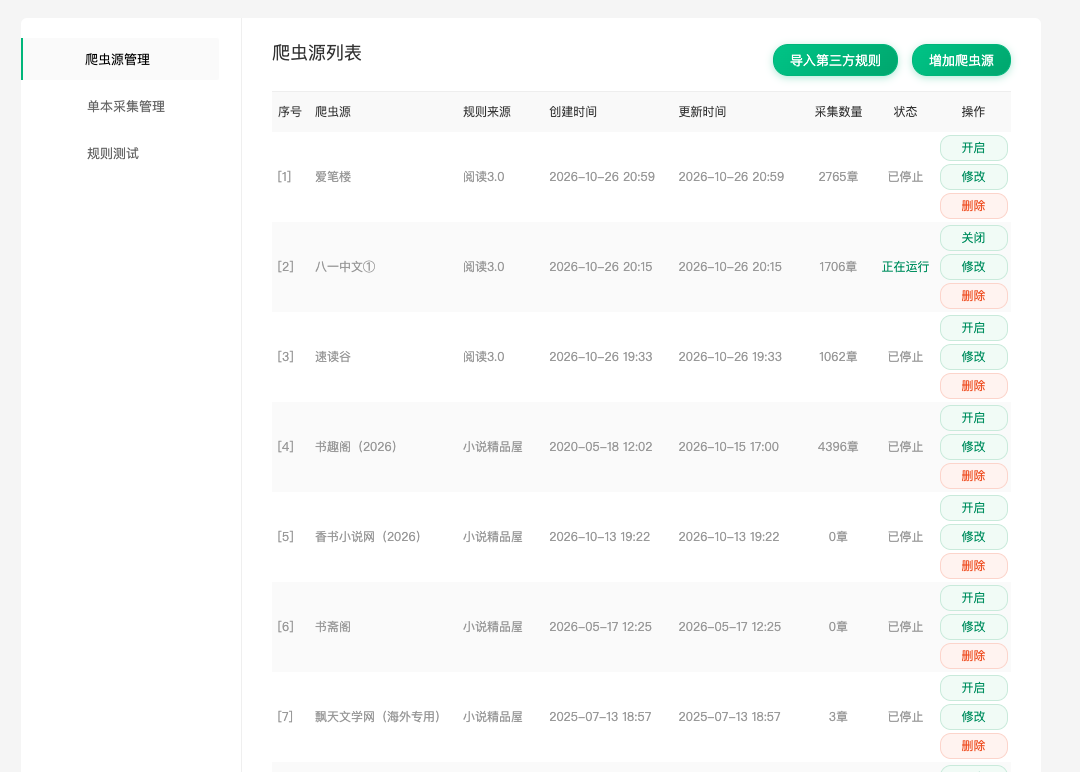
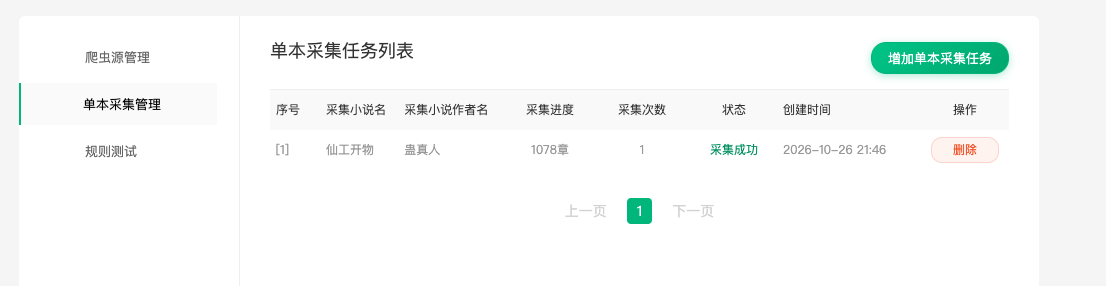
相关代码目前已经提交到 6.4.x 分支,计划在后续版本中正式发布。现阶段,这项功能还处于持续完善的过程中,暂时不能保证所有第三方规则都能直接导入使用。后续会继续完善规则兼容和导入逻辑,尽量减少手动修改规则的工作量。
CSS、XPath 和 JSONPath 虽然使用不同的表达式,但在 novel-plus 中,它们共用一套统一的取值后缀。掌握这套语法,就能应对大部分常见的采集需求。
| 写法 | 含义 | 示例 |
|---|---|---|
表达式 |
默认提取文本内容 | #bookName |
表达式::attr(名称) |
提取指定属性 | a.author::attr(href) |
表达式::html |
提取 HTML,保留标签 | #content::html |
表达式::ownText |
仅提取元素自身的直接文本,不包含子孙元素的文本 | div.intro::ownText |
表达式|后端正则 |
提取结果后,再用正则表达式进行二次处理,优先取第 1 个捕获组 | dl dd a::attr(href)|/(\d+)\.html |
表达式##正则##替换 |
对提取结果进行正则替换;省略替换内容时,默认删除匹配部分 | .content::html##[((]本章完[))] |
这里特别推荐 |后端正则 这种写法。
例如,某个章节链接是 https://example.com/book/12345.html,而我们只需要其中的章节 ID 12345,就可以直接写:
1 | a::attr(href)|/(\d+)\.html |
先提取链接的 href 属性,再通过正则表达式提取章节 ID,无须额外编写处理逻辑。
另一种常用写法是 ##正则##替换,可以在提取内容后进一步清理文本。例如,删除正文末尾的“本章完”等标记。该语法也兼容阅读 3.0 中的 ## 过滤写法。
除了取值后缀,还有一种 规则级解析前缀,可以为单条规则单独指定解析方式,优先级高于整源的默认解析设置。
目前支持以下前缀:
css::使用 CSS 选择器xpath::使用 XPathjson::使用 JSONPathregex::使用正则表达式
例如,整本书源默认使用 CSS,但某个字段更适合通过 XPath 提取,就可以这样写:
1 | xpath://meta[@property='og:novel:author']/@content |
这样,同一个书源中就可以混合使用不同的解析方式,不必为了某个特殊字段改变整源的配置。
CSS 选择器基于 jsoup 实现,语法与浏览器中的 querySelector 等选择器比较接近。如果平时经常使用浏览器开发者工具查看网页结构,通常可以比较快地上手。
1 | #bookName 取书名文本 |
这里有一个需要注意的地方是 novel-plus 对 :eq(n) 做了特殊处理。
在 novel-plus 中,:eq(n) 表示选取第 n 个匹配元素;而 jsoup 原生的 :eq(n) 语义是选取父节点下索引为 n 的子元素,两者的含义并不相同。
例如:
1 | #list:eq(0) a |
表示先选取第一个匹配 #list 的元素,再提取其中的 a 元素。
不包含 :eq( 的选择器仍按 jsoup 原生规则解析。
XPath 同样基于 jsoup 的 selectXpath 实现。对于已经熟悉 XPath 的用户,可以直接使用常见的路径表达式,不必重新学习 CSS 选择器。
1 | //h1[@class='bookname'] 取书名文本 |
XPath 表达式既可以返回元素,也可以返回文本节点或属性值。例如,text() 和 @attr 这类表达式都可以正常处理,无须为了适配取值逻辑而额外修改规则。
正则表达式是 novel-plus 原有的解析方式,本次升级并没有取消它,而是在保留原有能力的基础上增加其他选项。
其提取规则是 有捕获组时,优先取第 1 个捕获组;没有捕获组时,取整个匹配结果。
例如:
1 | <h1 class="title">(.*?)</h1> 取书名 |
对于历史上没有配置解析方式字段的爬虫规则,系统仍默认按照正则表达式处理,尽可能保证旧书源继续兼容,不需要为了升级而批量修改现有规则。
有些站点的数据并不是直接写在 HTML 页面中,而是通过接口返回 JSON。对于这类站点,JSONPath 往往比 CSS 或 XPath 更直接。
novel-plus 的 JSONPath 解析基于 Jayway JsonPath 实现,适合从接口响应中提取书名、作者、章节列表、正文等数据。
1 | $.data.bookName 取书名 |
其中,$.data.chapters[*].name 中的 [*] 表示匹配数组中的所有元素,可以一次提取多个章节名。
对于返回对象或数组的表达式,系统会将结果序列化为 JSON 文本返回,方便后续处理。
需要注意的是,JSONPath 更适合处理已经获取到的 JSON 响应。如果站点需要执行 JavaScript、完成特定请求签名或通过其他方式才能获取数据,仅仅更换解析表达式并不能解决这些问题。